Модель научилась удерживать геометрию объектов, понимать точечные команды на редактирование и без ошибок писать слова на любых языках. Разберем, как устроена нейросеть, в чем разница между ее версиями Flare и Sunburst и как выжимать из нее максимум.
Главные особенности GPT Image 2.5
Модель собрана на обновленной мультимодальной архитектуре и закрывает три ключевые боли контент-мейкеров и дизайнеров:
- Консистентность персонажей и объектов. Нейросеть запоминает пропорции лица, одежду и мелкие детали. Вы можете переносить одного и того же героя в разные локации без потери узнаваемости.
- Точечные правки без разрушения кадра. Если дать команду «замени фон на пляж, оставив человека и позу», модель заменит только фон. Лицо, руки и одежда останутся нетронутыми.
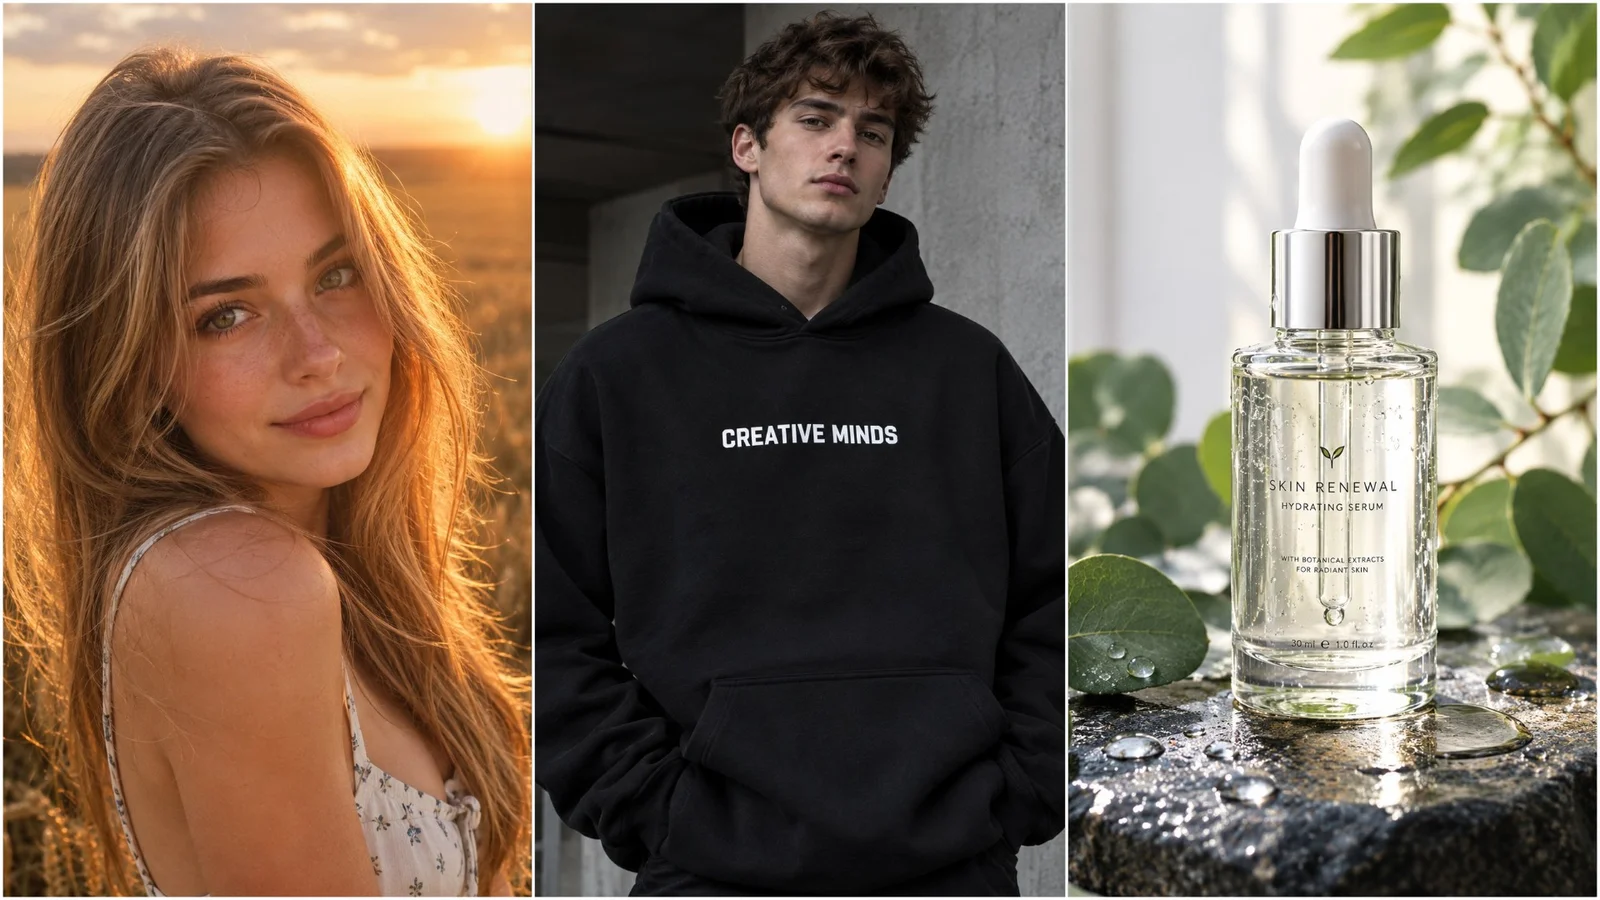
- Четкая типографика. Текст на этикетках, баннерах, футболках и вывесках больше не превращается в бессвязные закорючки. Буквы рендерятся ровно так, как вы их написали в запросе.
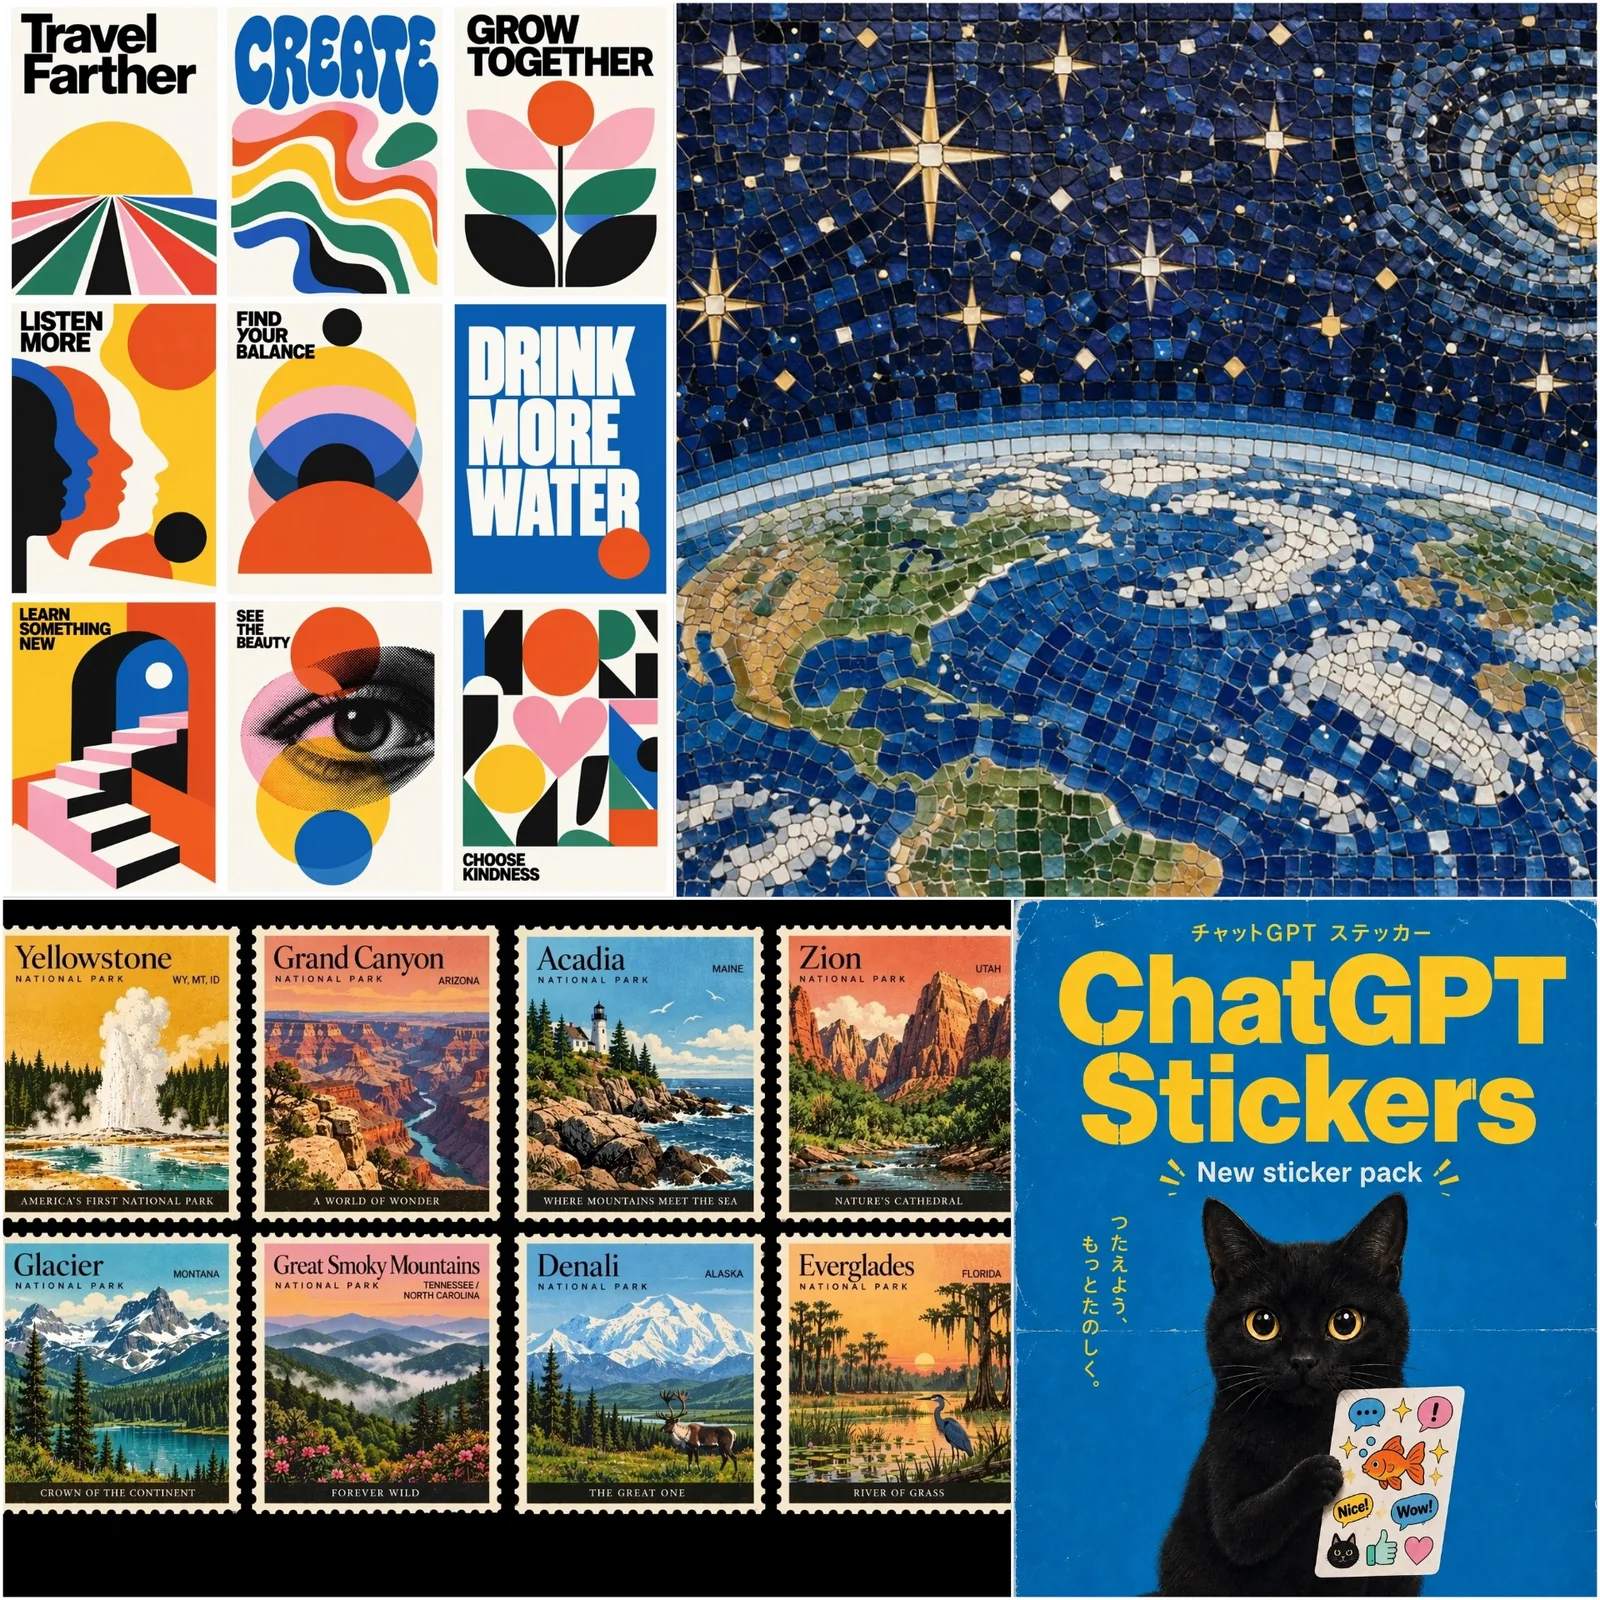
Примеры генерации GPT Image 2.5
Flare против Sunburst: какой режим включить
В GPT Image 2.5 встроены два движка генерации под разные сценарии работы:
| Параметр | GPT Image 2.5 Flare | GPT Image 2.5 Sunburst |
|---|---|---|
| Основной упор | Высокая скорость и фотореализм текстур | Глубокий свет и художественная детализация |
| Время генерации | 15–25 секунд | 30–50 секунд |
| Сфера применения | Контент для соцсетей, аватарки, карточки товаров | Афиши, постеры, кинокадры, сложный арт |
| Работа с референсом | Строго держит форму и геометрию | Тонко переносит свет и атмосферу |
Для ежедневной работы с карточками товаров, фотосессиями или иллюстрациями для постов включайте Flare — она генерирует в два раза быстрее. Если готовите обложку альбома, кинематографичный постер или сложную арт-сцену со сложными световыми схемами — выбирайте Sunburst.
Поддерживаемые форматы и разрешение
Модель поддерживает 13 вариантов соотношения сторон, поэтому вам не придется вручную обрезать картинки в графических редакторах:
- Квадратные: 1:1 (посты, аватарки).
- Вертикальные: 9:16 (Stories, Reels, Shorts), 3:4, 2:3, 16:27, 8:9.
- Горизонтальные: 16:9 (видео, сайты), 4:3, 3:2, 21:9 (кинематографичный формат), 27:16, 9:8.
- Авто: нейросеть сама определяет пропорции под сюжет промпта.
По качеству доступны три уровня: 1K (быстрый черновик), 2K (стандарт для веба) и 4K (для широкоформатной печати и сложного монтажа).
Как составить промпт: простая формула
Для стабильного результата держитесь базовой структуры: Объект + Окружение + Освещение/Стиль + Камера/Детали.
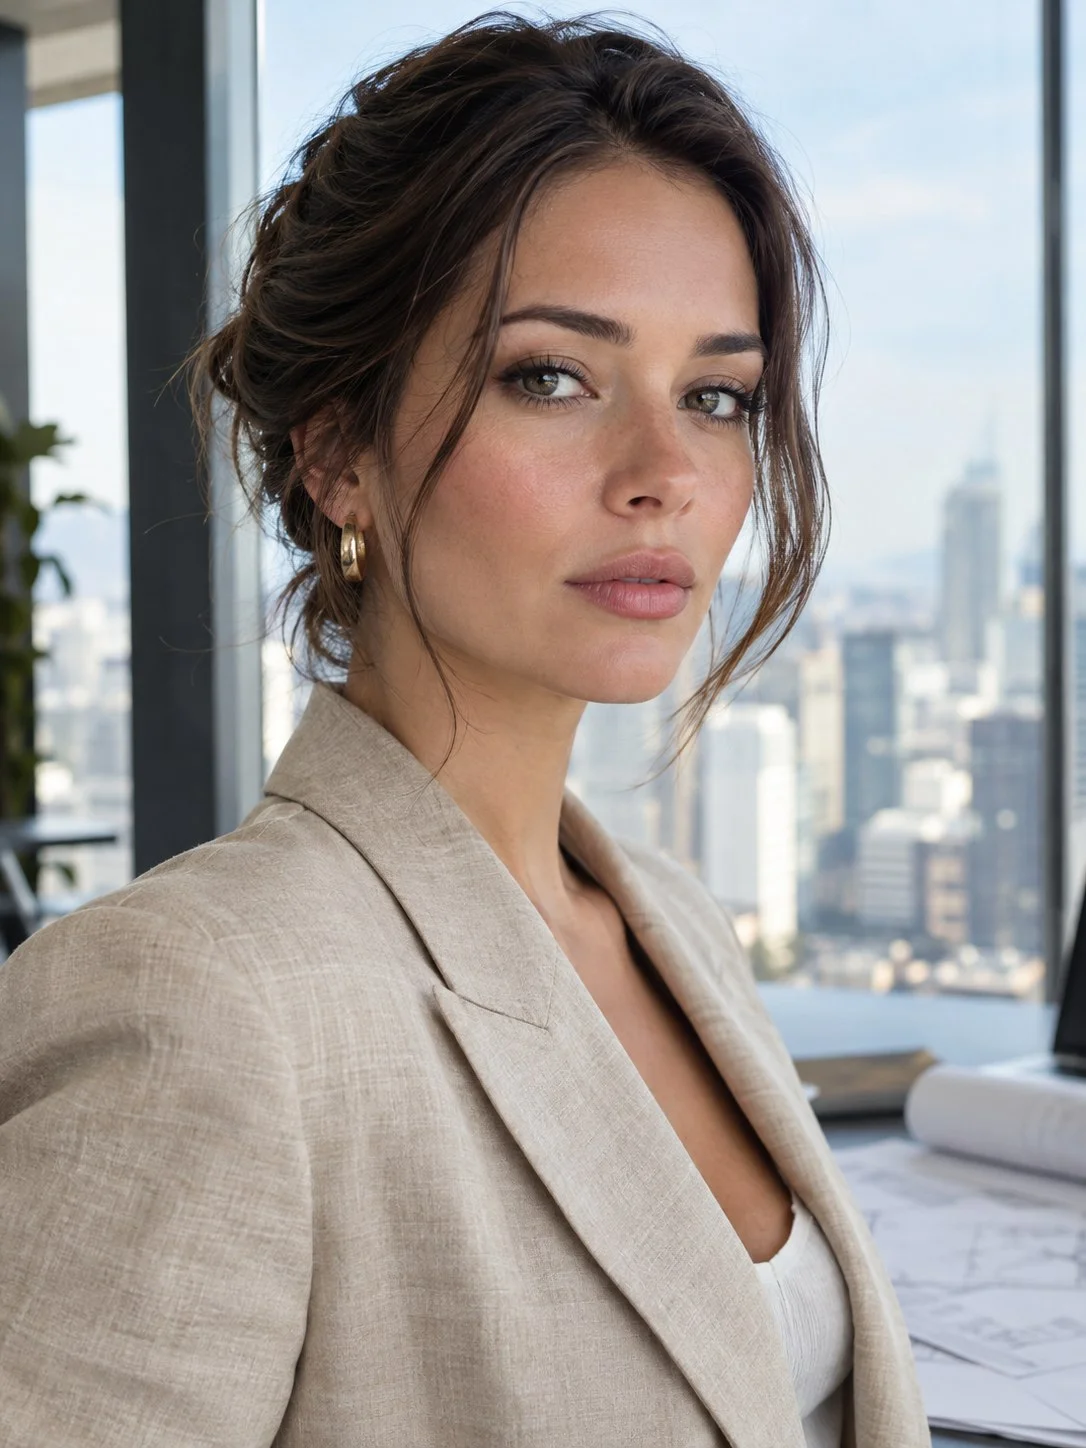
Пример 1. Фотореалистичный бизнес-портрет
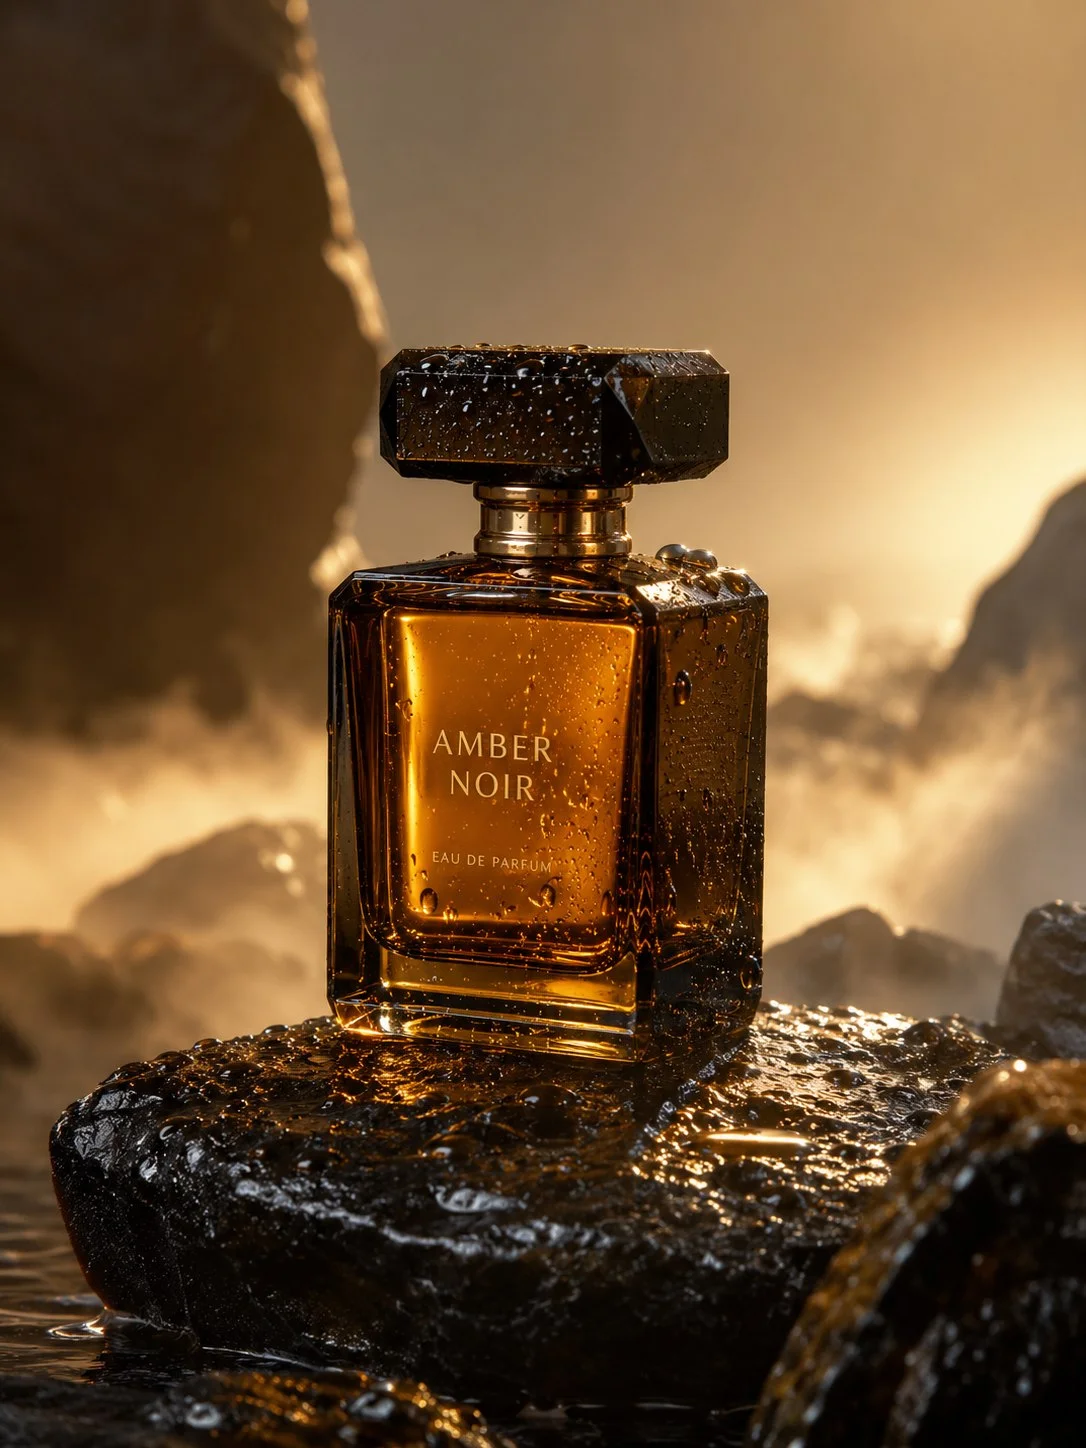
Пример 2. Предметная съемка для маркетплейса
Редактирование фото по референсу (Image-to-Image)
Чтобы модифицировать уже готовый кадр, загрузите от 1 до 6 изображений и четко укажите два момента: что заменить и что обязательно сохранить.
- Замена фона: «Возьми человека с референса. Перенеси его на вечернюю улицу Токио с мокрым асфальтом и неоновыми вывесками. Сохрани черты лица, прическу, позу и одежду исходного фото.»
- Смена одежды: «Замени серую толстовку на строгий темно-синий костюм-тройку. Лицо, волосы, позу и фон оставь прежними.»
- Стилизация: «Перерисуй фотографию в стиле винтажной пленочной фотографии 90-х с легким пленочным зерном и теплыми аналоговыми цветами.»
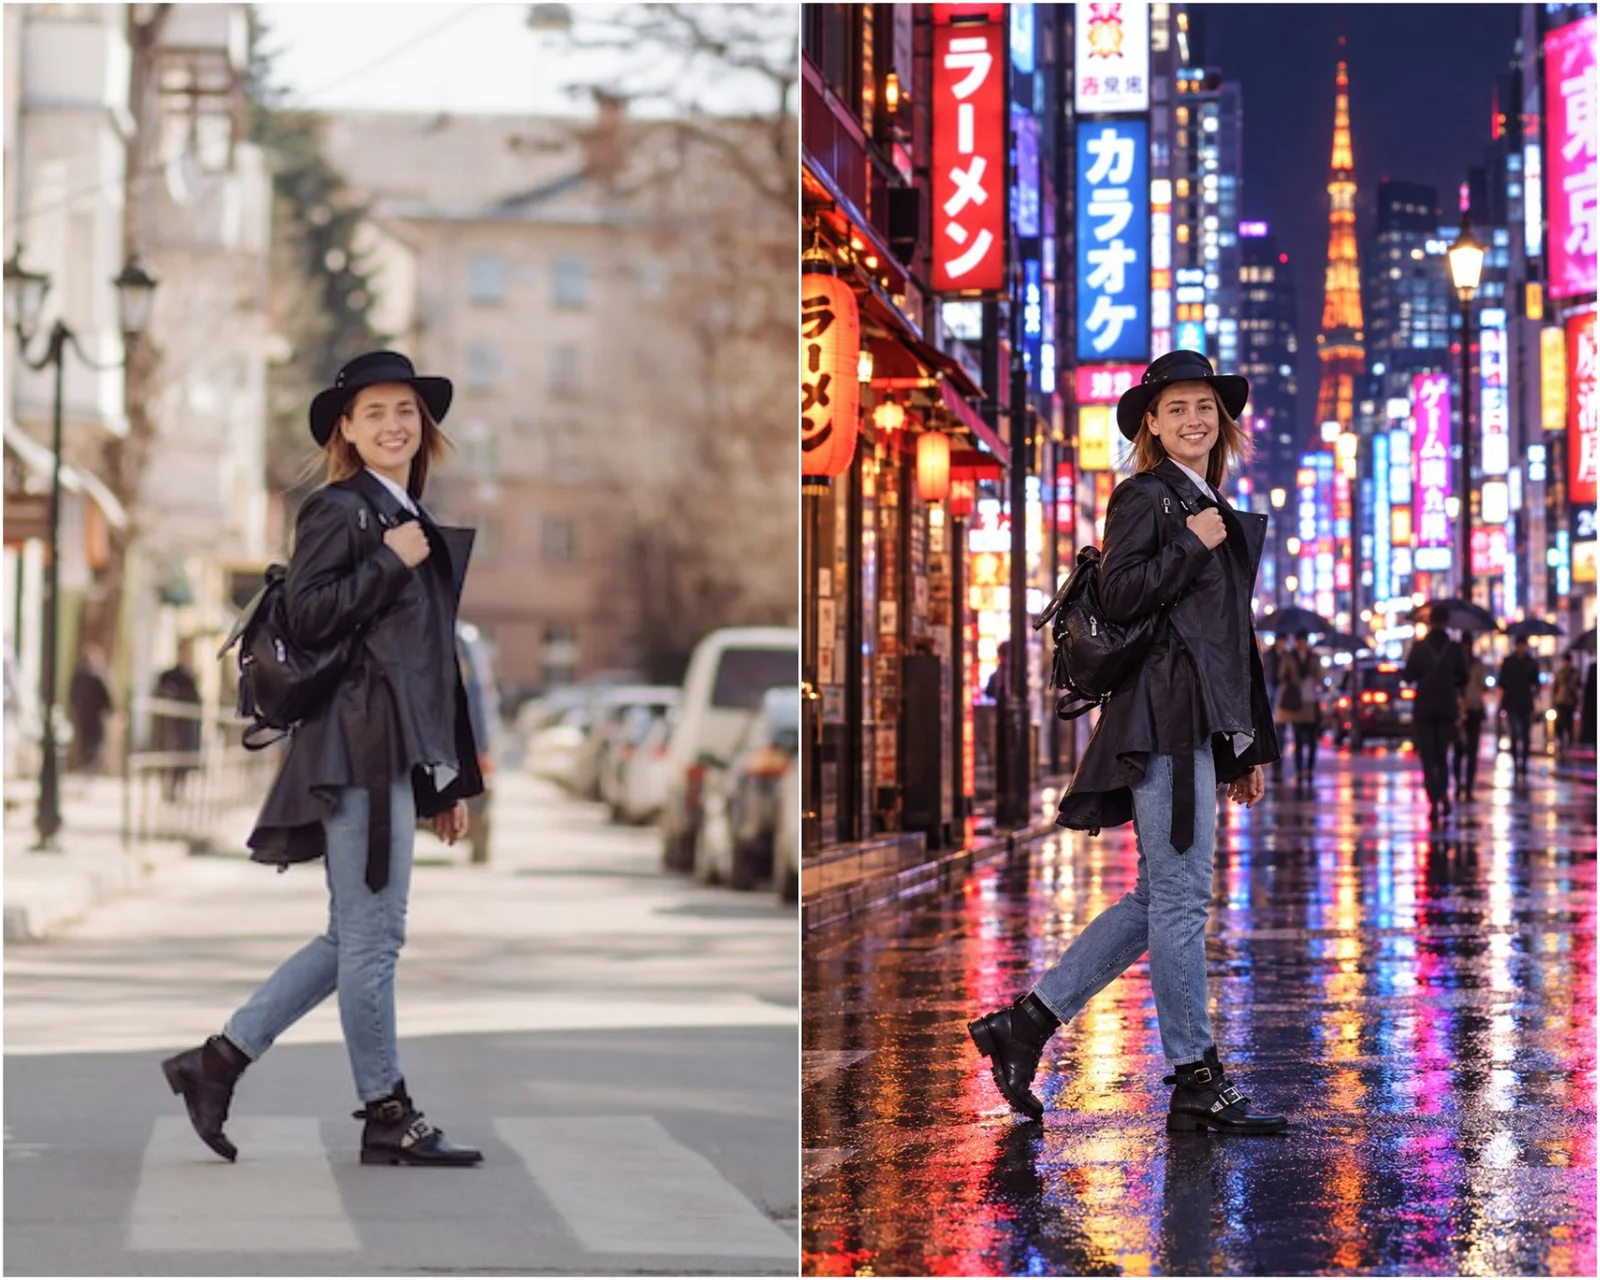
Пример редактирования фото по промпту
5 частых ошибок при работе с моделью
- Размытые формулировки. Запрос «красивый парень на улице» дает непредсказуемый результат. Указывайте возраст, ракурс, одежду и время суток.
- Забытый формат. Если вам нужна вертикалка под Shorts или Reels, укажите формат 9:16 до генерации, чтобы не терять композицию при ручной обрезке.
- Попытка уместить всё в один запрос. Не пытайтесь сгенерировать 15 мелких деталей за один проход. Сделайте базовый кадр, а затем точечно добавьте детали вторым шагом через правку референса.
- Отсутствие негативных указаний при правках. Если не написать фразу «сохрани лицо исходного фото», нейросеть может слегка изменить разрез глаз или форму носа.
- Смайлики и лишний шум. Смайлы в тексте промпта путают языковой модуль. Пишите емкими, простыми предложениями с конкретными терминами съемки.

Все топовые ИИ без подписок
Где запустить GPT Image 2.5
Выбирайте площадку под свои условия и доступные платежные методы:
1. Официальный веб-интерфейс ChatGPT
- Адрес: chatgpt.com
- Как пользоваться: Авторизуйтесь, выберите режим «Create Image» и отправьте текстовый запрос.
- Нюансы: Требуется зарубежный IP-адрес и иностранная банковская карта для оплаты подписки Plus ($20 в месяц).
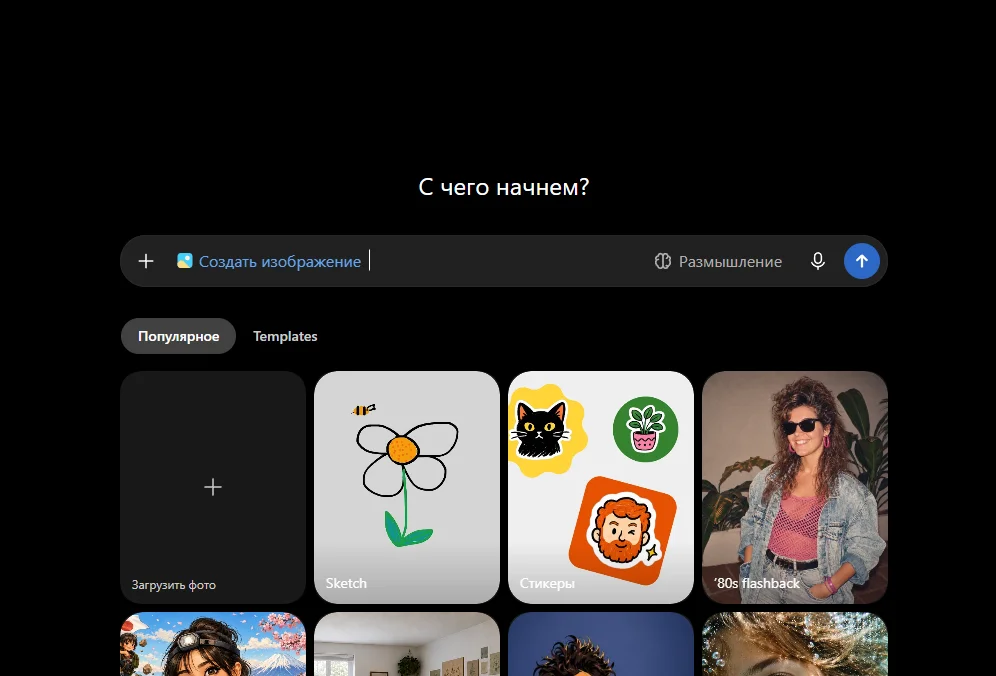
Интерфейс Chatgpt.com для генерации изображений в GPT Image 2.5
2. Телеграм-бот
- Ссылка: t.me/NeuroNavigator_bot
- Как пользоваться: Откройте меню «Фото и изображения» ➔ «GPT Image».
- Нюансы: Работает прямо в мессенджере без VPN. В настройках можно переключать режимы Flare / Sunburst, выбирать любое из 13 соотношений сторон и выставлять качество 1K/2K/4K. Доступен бесплатный тест, оплата поштучно за токены.
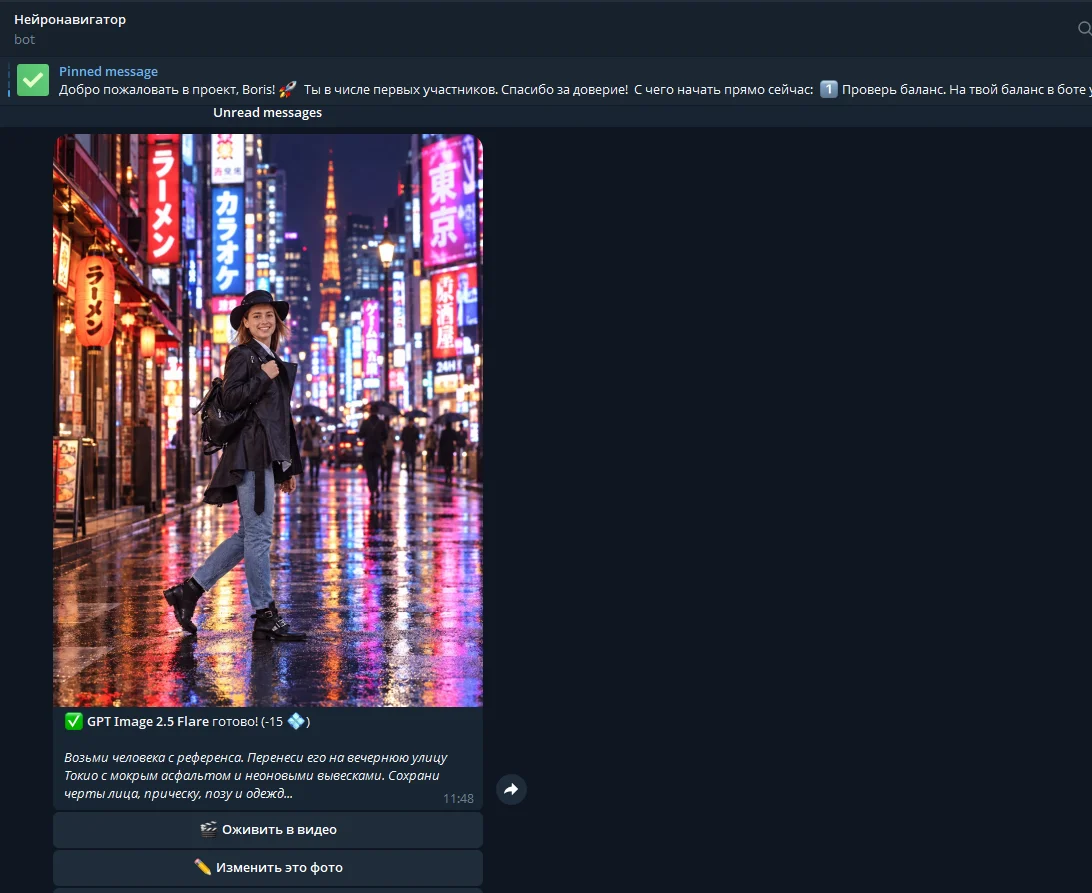
Интерфейс Телеграм-бота Нейронавигатор
3. Российская ИИ-платформа (нейростудия)
- Адрес: neyro.pro/studio
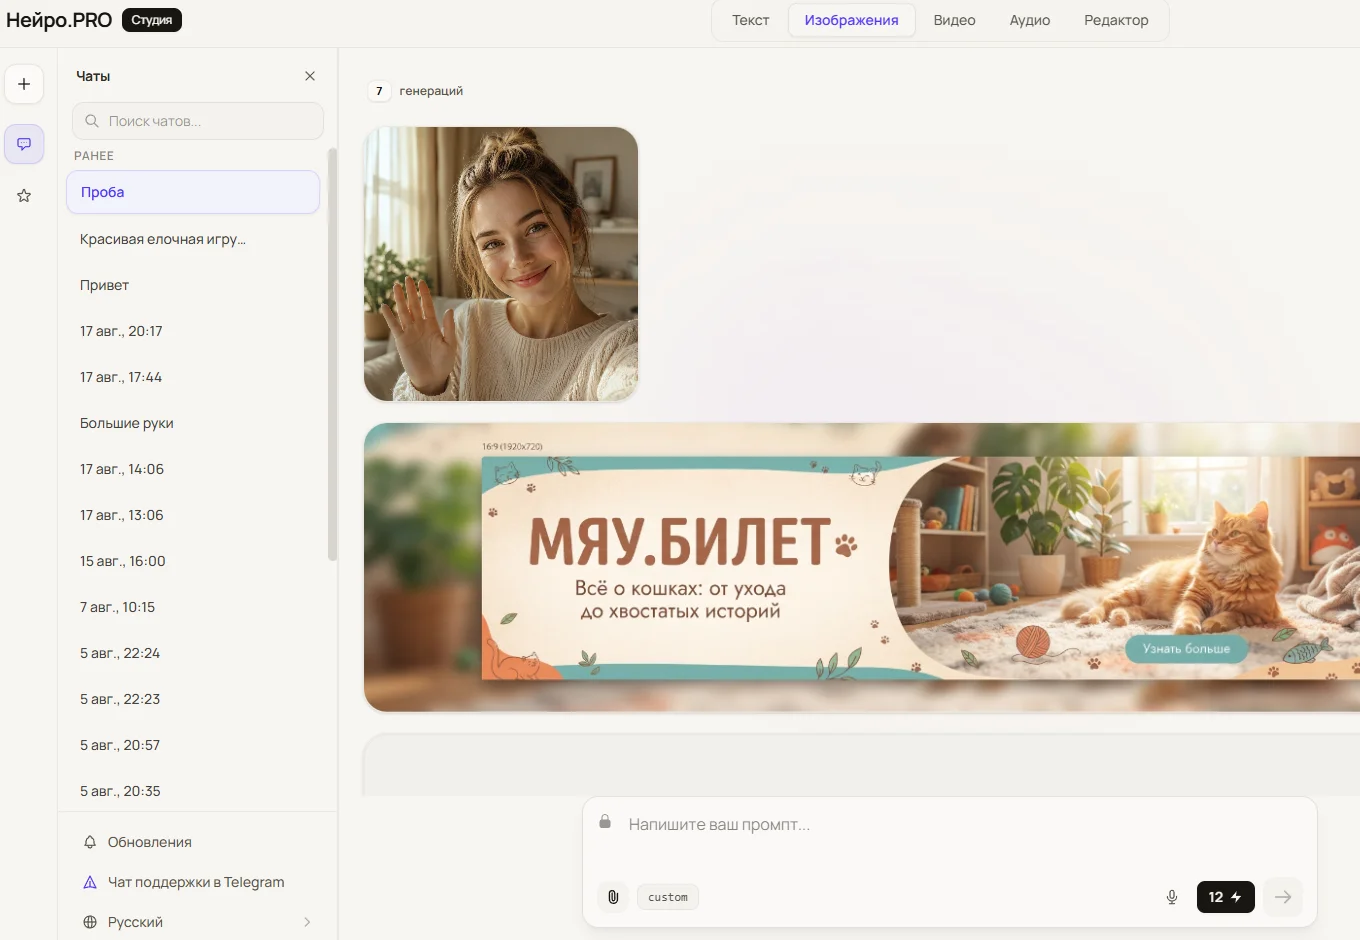
- Как пользоваться: Зайдите на платформу через браузер и выберите модель GPT Image 2.5.
- Нюансы: Работает напрямую из РФ без VPN. Оплата картами МИР или через СБП без ежемесячных подписок. При регистрации начисляются приветственные токены на первые генерации.
💡 Ключевые термины
- GPT Image Flare — скоростной режим генерации в GPT Image 2.5, оптимизированный под текстуры и быстрый рендер за 15–25 секунд.
- GPT Image Sunburst — режим углубленного рендера с упором на кинематографичный свет, объемные тени и сложный арт.
- Image-to-Image — режим генерации, при котором нейросеть берет загруженную картинку за основу и вносит в нее точечные изменения по текстовой команде.
- Консистентность (Consistency) — способность нейросети сохранять узнаваемость лица, пропорции и стиль объекта от кадра к кадру.
- Соотношение сторон (Aspect Ratio) — пропорция ширины и высоты генерируемого изображения (например, 16:9 для горизонтальных экранов или 9:16 для мобильных видео).
- Промпт (Prompt) — текстовая инструкция, описывающая объект, окружение, освещение и композицию будущего кадра.
---
Вопросы и ответы (FAQ)
В чем главное отличие GPT Image 2.5 от старой DALL-E 3?
Новая модель на порядок стабильнее держит композицию, безошибочно генерирует читаемый текст и поддерживает пошаговые правки по референсам без перерисовки всего кадра.
Понимает ли нейросеть русский язык?
Да, модель свободно обрабатывает промпты на русском языке без потери деталей и подтекста.
Сколько референсов можно загружать одновременно?
Вы можете прикрепить до 6 фотографий в одном запросе, чтобы взять лицо с одного фото, позу со второго, а цветовую палитру — с третьего.

Пока нет комментариев. Будьте первым!