
Осень 2026 года окончательно перекроила правила поиска информации в интернете. Если еще год назад генеративные ответы воспринимались как экспериментальная надстройка над привычной выдачей, то после осенних релизов Google и OpenAI они стали основной точкой входа для коммерческого и исследовательского трафика. 15 октября Google перестроил логику отображения ссылок в AI Mode и AI Overviews, 10 ноября запустил ноябрьский Core Update, а 12 ноября перевел AI Mode на новую модель Gemini 4 Hydrogen. В те же дни, 10 ноября, OpenAI открыла бета-версию Businesses in ChatGPT с кабинетом Business Hub, впервые дав владельцам сайтов прямую аналитику упоминаний и переходов из диалогов с нейросетью.
Для бизнеса, редакций и SEO-специалистов это означает смену самой парадигмы. Попасть в топ-10 синих ссылок больше недостаточно: если ваш сайт не попадает в синтезированный ответ нейросети, значительная часть аудитории до вас просто не дойдет. На смену классическому SEO приходит GEO (Generative Engine Optimization) — оптимизация контента и технической инфраструктуры сайта под алгоритмы генеративных поисковых систем.
Краткая выжимка (TL;DR) для быстрого старта:
- Разделяйте ботов обучения и поиска: блокировка
GPTBotилиClaudeBotзащищает тексты от попадания в обучающие датасеты, но не мешает цитированию. А вот запрет дляOAI-SearchBot,Claude-SearchBotилиPerplexityBotполностью вычеркивает сайт из поисковых ответов ИИ. - Подтвердите бренд в OpenAI Business Hub: запущенный 10 ноября 2026 года кабинет позволяет привязать домен компании, видеть статистику упоминаний в ChatGPT и отслеживать реальные клики.
- Пишите под веерные подзапросы (Query Fan-Out): нейросети редко ищут по одному высокочастотному ключу — они разбивают вопрос пользователя на уточняющие запросы со словами
2026,officialиprice, отдавая приоритет первоисточникам. - Формулируйте готовые тезисы: после октябрьского апдейта Google встраивает ссылки прямо в ключевые фразы первых абзацев ответа, а Gemini 4 Hydrogen активно переносит в выдачу готовые HTML-таблицы.
- Не тратьте ресурсы на
llms.txt: в документации Google Search Central официально подтверждено, что поиск Google и AI Overviews игнорируют этот файл.
1. Экономика нового поиска: почему трафик из ИИ стал самым дорогим и конверсионным
Долгое время главным страхом владельцев сайтов оставался феномен zero-click — ситуация, когда пользователь получает ответ прямо на странице поисковика и закрывает вкладку, не совершив перехода. Однако статистика конца 2026 года показывает, что генеративный поиск не просто забирает часть информационных кликов, а радикально меняет структуру воронки продаж.
По данным исследования Semrush (август 2026), блок Google AI Overviews уже отображается в 88% запросов с коммерческими модификаторами, а замеры SE Ranking (октябрь 2026) фиксируют его появление в 82,5% брендовых запросов в США. Параллельно недельная аудитория ChatGPT достигла 1,2 миллиарда человек. Иными словами, подавляющее большинство покупателей сегодня начинает выбор товара, подрядчика или B2B-сервиса с диалога с нейросетью.
Самое важное для бизнеса — качество тех кликов, которые все-таки уходят на сайты из ИИ-выдачи. В отчете Adobe Digital Insights от 29 октября 2026 года проанализированы миллионы сессий в ритейле и сервисах. Выяснилось, что посетители, пришедшие из генеративных поисковиков, приносят компаниям на 83% больше выручки на визит (Revenue Per Visit) и конвертируются на 90% лучше, чем пользователи из классической органики. Они проводят на сайте на 59% больше времени, а показатель отказов среди них на 34% ниже.
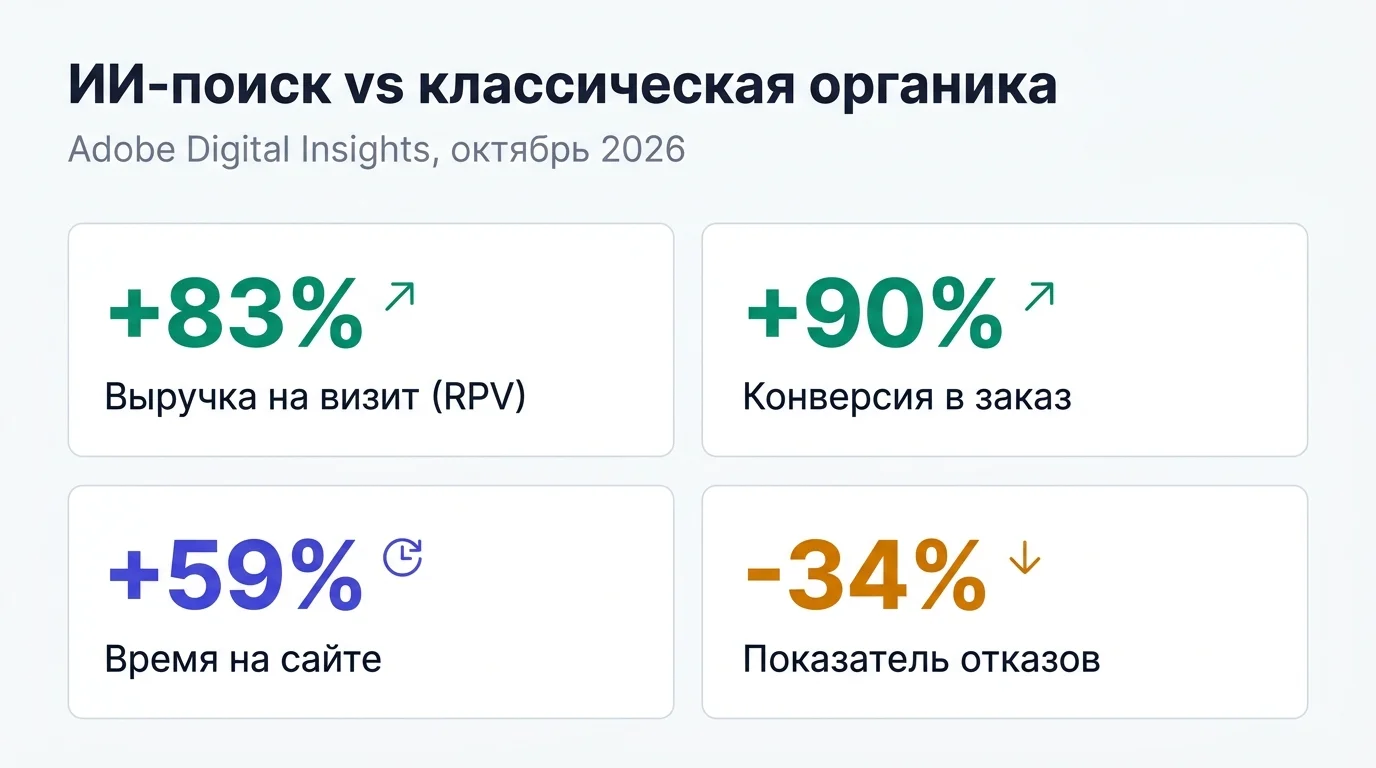
Качество трафика из ИИ-поиска по сравнению с классической органикой (Adobe Digital Insights, октябрь 2026)
Причина такой разницы кроется в психологии взаимодействия с ИИ. В классическом поиске человек открывает пять-семь вкладок, бегло сканирует цены, закрывает неподходящие сайты (генерируя отказы) и только потом принимает решение. В генеративном поиске весь этап первичного отсева и сравнения происходит внутри диалогового окна до первого клика. Нейросеть уже отфильтровала неподходящие варианты, сверила характеристики и объяснила, почему конкретный продукт решает задачу пользователя. При этом 89% людей кликают по ссылкам на источники внутри ответа ИИ, а 66% целенаправленно переходят на официальный сайт бренда, чтобы перепроверить рекомендацию и оформить заказ. Клиент приходит на сайт уже прогретым.
| Критерий | Классическое SEO | GEO (Generative Engine Optimization) |
|---|---|---|
| Главная цель | Занять место в топ-10 органической выдачи | Стать источником для синтезированного ответа и инлайн-ссылок ИИ |
| Ключевые метрики | Позиции по семантическому ядру, органический CTR | Доля упоминаний бренда (Mentions), реферальные клики из ИИ |
| Характер запросов | Короткие ключевые фразы из 2–4 слов | Развернутые промпты и цепочки уточняющих вопросов |
| Архитектура контента | Тексты с равномерным распределением ключевых слов | Плотные факты, готовые определения, сравнительные HTML-таблицы |
| Ключевые краулеры | Googlebot, Bingbot, YandexBot | OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot |
2. Как нейросети ищут информацию: RAG, Query Fan-Out и разворот в сторону брендов
Чтобы понимать, как оптимизировать сайт под генеративные системы, нужно разобраться в механике их работы. Современные языковые модели используют архитектуру RAG (Retrieval-Augmented Generation — генерация, дополненная поиском). Когда пользователь задает вопрос, модель оценивает, достаточно ли ей собственных базовых знаний (весов), полученных при обучении. Если вопрос касается актуальных цен, свежих релизов, локальных услуг или конкретных характеристик товара, модель включает поиск в реальном времени.
Согласно масштабному исследованию Ahrefs (октябрь 2026), охватившему 66,6 миллиона ответов ChatGPT и 15 миллионов поисковых подзапросов, выход в интернет запускается только в 14,4% всех диалогов. В остальных 85,6% случаев ChatGPT отвечает, опираясь исключительно на то, что уже «запомнил» на этапе обучения. Но когда поиск все-таки активируется, в дело вступает технология Query Fan-Out (веерные запросы).
Суть Query Fan-Out заключается в том, что нейросеть не отправляет в поисковую строку промпт пользователя целиком. Вместо этого она выступает как опытный исследователь: дробит сложный вопрос на несколько фоновых поисковых подзапросов (в среднем 1,6 подзапроса на один ответ в ChatGPT), чтобы собрать факты с разных ракурсов. По данным исследования Surfer (октябрь 2026), средняя длина такого фонового подзапроса составляет около 12 слов.
Разберем это на живом примере. Представьте, что руководитель небольшой строительной компании спрашивает у ChatGPT: «Какую CRM-систему выбрать для бригады из 15 человек, чтобы прорабы могли отправлять фотоотчеты прямо из Telegram, и сколько это будет стоить?»
Модель раскладывает этот промпт на веер подзапросов:
лучшие CRM для строительных компаний интеграция Telegram 2026CRM для прорабов фотоотчеты Telegram отзывы сравнение[Название популярной CRM] official price тарифы 15 пользователей 2026
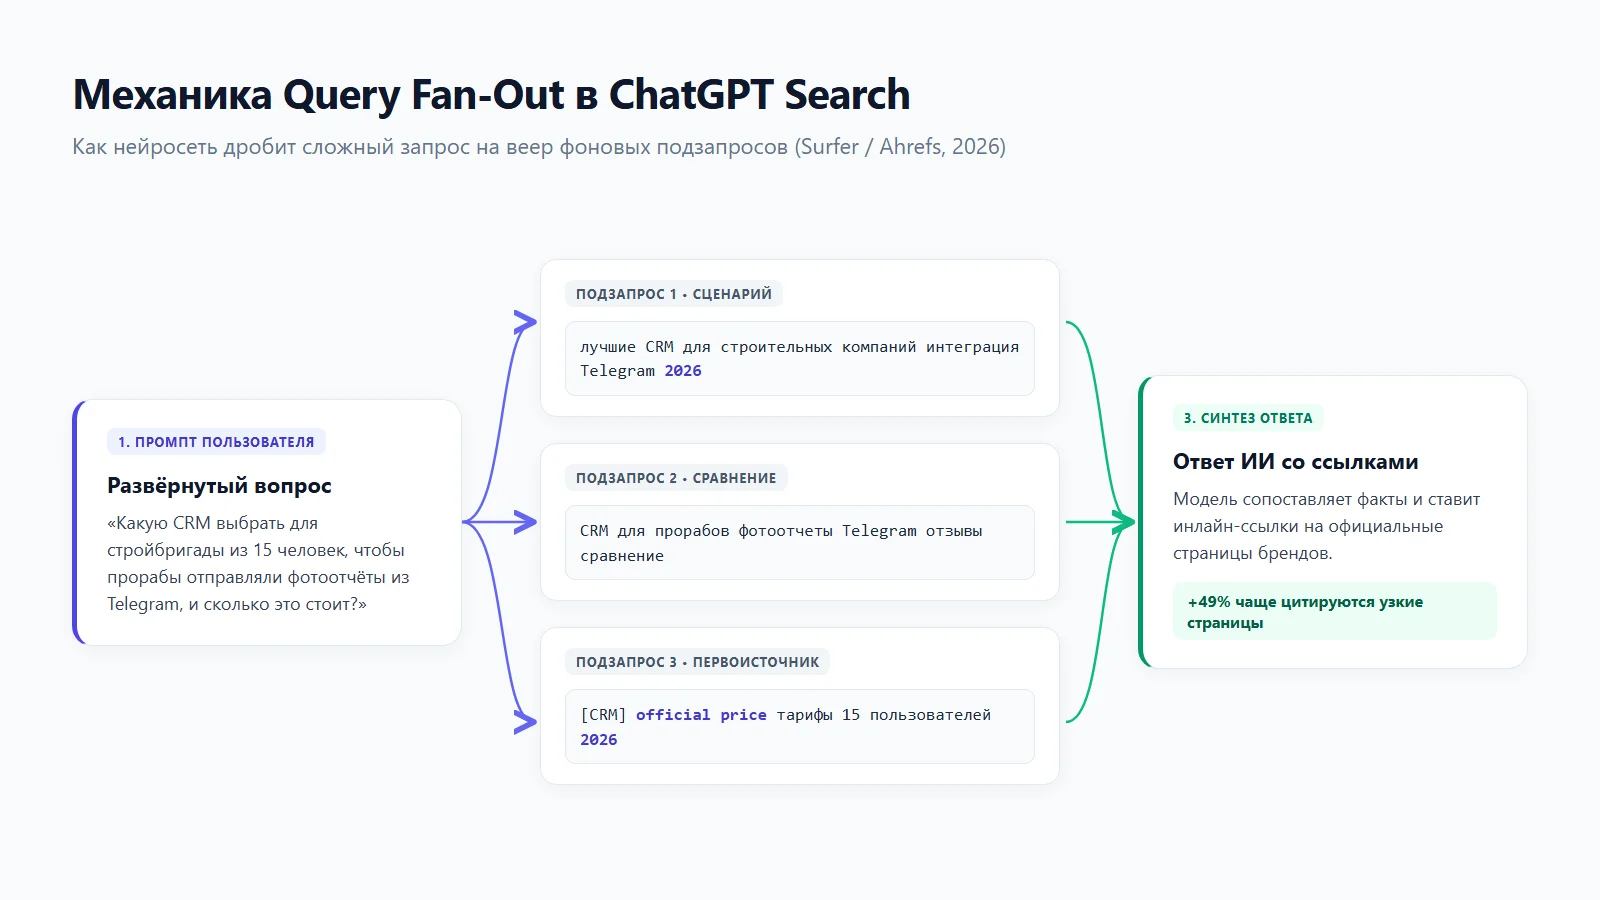
Механика Query Fan-Out: как ChatGPT Search дробит сложный запрос на веер фоновых подзапросов
Далее нейросеть сканирует выдачу по каждому из этих подзапросов, сопоставляет цифры и формулирует единый ответ. Исследование Surfer показало критически важную закономерность для контент-маркетинга: страницы, которые ранжируются именно по таким узким подтемам (fan-outs), цитируются в ответах ИИ на 49% чаще (коэффициент цитирования 29,2%), чем страницы, оптимизированные исключительно под главный высокочастотный ключ (19,6%). Пытаться закрыть все одним общим лендингом «CRM для бизнеса» больше не работает — выигрывают глубокие, узкоспециализированные страницы под конкретные сценарии.
Еще один фундаментальный сдвиг осени 2026 года — отказ нейросетей от слепого доверия форумам в пользу первоисточников. По данным Ahrefs, за полгода доля цитирования Reddit в ответах ChatGPT рухнула на 88%. Причина проста: пользователи и алгоритмы столкнулись с засильем устаревших или предвзятых комментариев, тогда как при выборе продукта людям нужны точные спецификации. Статистика подтверждает этот разворот: в 76% случаев, когда ChatGPT применяет поисковый оператор site:, он ищет информацию напрямую на официальном домене бренда. А самыми популярными словами в веерных подзапросах стали текущий год 2026 (22,9%), official (13,1%) и price (8,9%).
3. Три экосистемы ИИ-поиска: чем отличаются Google, ChatGPT и Perplexity
Ошибочно воспринимать «нейросети» как единый монолит с одинаковыми алгоритмами. У трех главных игроков рынка разные поисковые индексы, разная визуальная подача ссылок и разные приоритеты при отборе источников.
Google AI Overviews и AI Mode (на базе Gemini 4 Hydrogen)
Google строит генеративную выдачу поверх собственного основного поискового индекса — подавляющее большинство ссылок в AI Overviews по-прежнему отбирается из страниц, хорошо ранжирующихся в классической органике. Однако 15 октября 2026 года Google кардинально обновил интерфейс ссылок, признав, что издателям нужен заметный трафик, а 12 ноября перевел режим AI Mode (и сложные аналитические запросы в AI Overviews) на новую модель Gemini 4 Hydrogen.
В результате в выдаче Google появилось сразу несколько новых точек входа для сайтов:
- Инлайн-ссылки в первых абзацах: ссылки теперь встраиваются прямо в ключевые фразы в самом начале сгенерированного ответа, а не прячутся только в боковой колонке.
- Блок официальных источников (Official Sources): для запросов о брендах, тарифах и документах Google выделяет верхний блок с пояснением, почему конкретный сайт является первоисточником.
- Карточки похожих статей с миниатюрами: в нижней части ответа выводятся крупные визуальные карточки с превью-картинками, где качество обложки напрямую влияет на кликабельность.
- Приоритет для Preferred Sources: использование функции «Предпочитаемые источники» выросло с начала 2026 года более чем в 7 раз, и отмеченные пользователями издания получают приоритет в новостных каруселях AI Search.
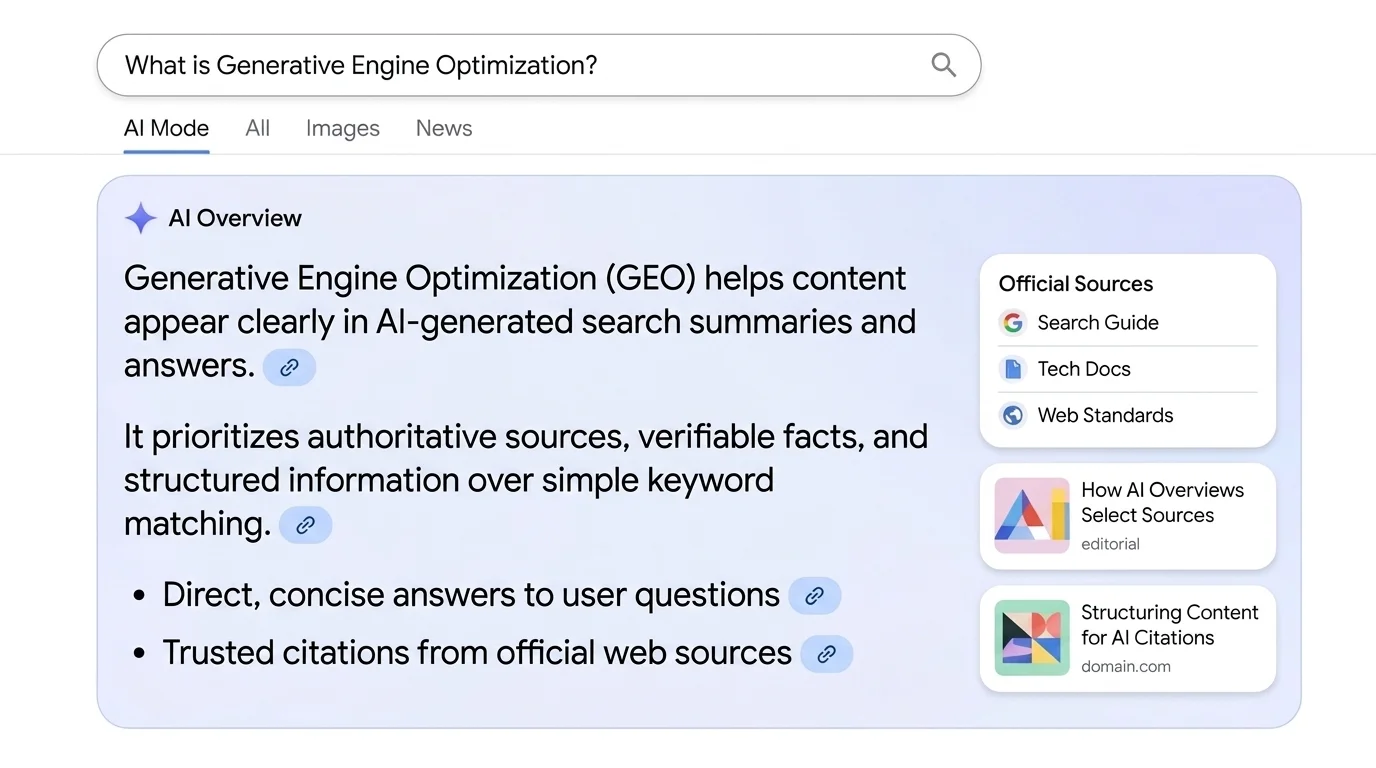
Формат выдачи Google AI Overviews и AI Mode: инлайн-ссылки в тексте, блок Official Sources и карточки статей
ChatGPT Search
Поисковый режим ChatGPT опирается на комбинацию индекса Bing, собственного краулера OAI-SearchBot и прямых товарных фидов, которые ритейлеры загружают в OpenAI. ChatGPT сильнее других привязан к официальным страницам брендов: если пользователь спрашивает о тарифах, условиях возврата или совместимости оборудования, модель в первую очередь пойдет на сайт производителя, а не на сторонний обзорник.
Perplexity
Perplexity использует собственный поисковый индекс (PerplexityBot) и позиционирует себя как исследовательский движок. В отличие от ChatGPT, который резко сократил долю форумов, Perplexity по-прежнему активно опирается на нишевые экспертные блоги, независимые сравнения и живые обсуждения на профильных площадках (включая Reddit и LinkedIn), сопоставляя официальные заявления брендов с пользовательским опытом.
4. Технический фундамент: как открыть сайт для ИИ-краулеров и настроить аналитику
Даже самый качественный экспертный текст не попадет в ответ нейросети, если боты поисковых систем не могут его прочитать. В 2026 году технический аудит GEO начинается с проверки доступа на уровне сервера и CDN.
Ловушка Cloudflare и разделение ботов в robots.txt
Многие владельцы сайтов, пытаясь защитить контент от парсинга, активировали в Cloudflare или других WAF-системах кнопку «Block AI scrapers» или закрыли в robots.txt все известные юзер-агенты нейросетей. На практике это приводит к тому, что сайт мгновенно пропадает из ChatGPT Search и Perplexity.
Разработчики ИИ разделили своих краулеров на три функциональные группы:
- Поисковые краулеры (индексируют сайт для выдачи ссылок):
OAI-SearchBot(OpenAI),Claude-SearchBot(Anthropic),PerplexityBot(Perplexity), а также классическиеGooglebotиBingbot. Их блокировать нельзя. - Юзер-фетчеры (загружают страницу по запросу пользователя в реальном времени):
ChatGPT-User,Claude-User,Perplexity-User. Когда пользователь просит нейросеть «проанализируй эту ссылку» или модель проверяет актуальную цену перед ответом, запрос идет именно от этих агентов. - Боты для обучения моделей (собирают данные в обучающие датасеты):
GPTBot(OpenAI),ClaudeBot(Anthropic),Google-Extended(Google).
Если ваша цель — запретить использование статей для обучения будущих нейросетей, но сохранить максимальную видимость в AI-поиске, конфигурация robots.txt должна выглядеть так:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /
После правки robots.txt обязательно проверьте серверные логи за последние 48 часов: убедитесь, что OAI-SearchBot и PerplexityBot получают код ответа 200 OK, а не отбиваются фаерволом хостинга с ошибкой 403 Forbidden. Также критически важен рендеринг: многие ИИ-парсеры не исполняют тяжелый клиентский JavaScript. Если цены, характеристики или основной текст статьи подгружаются через SPA-фреймворки без серверного рендеринга (SSR), нейросеть увидит пустую страницу.
Регистрация в ChatGPT Business Hub и загрузка товарных фидов
С запуском бета-версии Businesses in ChatGPT 10 ноября 2026 года у бизнеса появился официальный инструмент взаимодействия с экосистемой OpenAI — панель Business Hub. Первым делом необходимо пройти верификацию компании и подтвердить права на домен (Claim your business). Это связывает бренд с официальным источником данных и открывает доступ к аналитике: в интерфейсе Business Hub отображается, сколько раз нейросеть упомянула вашу компанию в диалогах и сколько переходов получил сайт.
Для интернет-магазинов и маркетплейсов критическим шагом стала передача структурированных каталогов. В соответствии со спецификацией OpenAI, опубликованной в сентябре 2026 года (developers.openai.com/ads/product-feeds), для попадания товаров в шопинг-блоки и рекомендации ChatGPT необходимо настроить регулярную выгрузку CSV-фида через API или SFTP. В файле обязательно должен передаваться актуальный остаток, цена, прямая ссылка на карточку товара и служебный флаг is_eligible_search=true, разрешающий показ позиции в поисковых ответах.
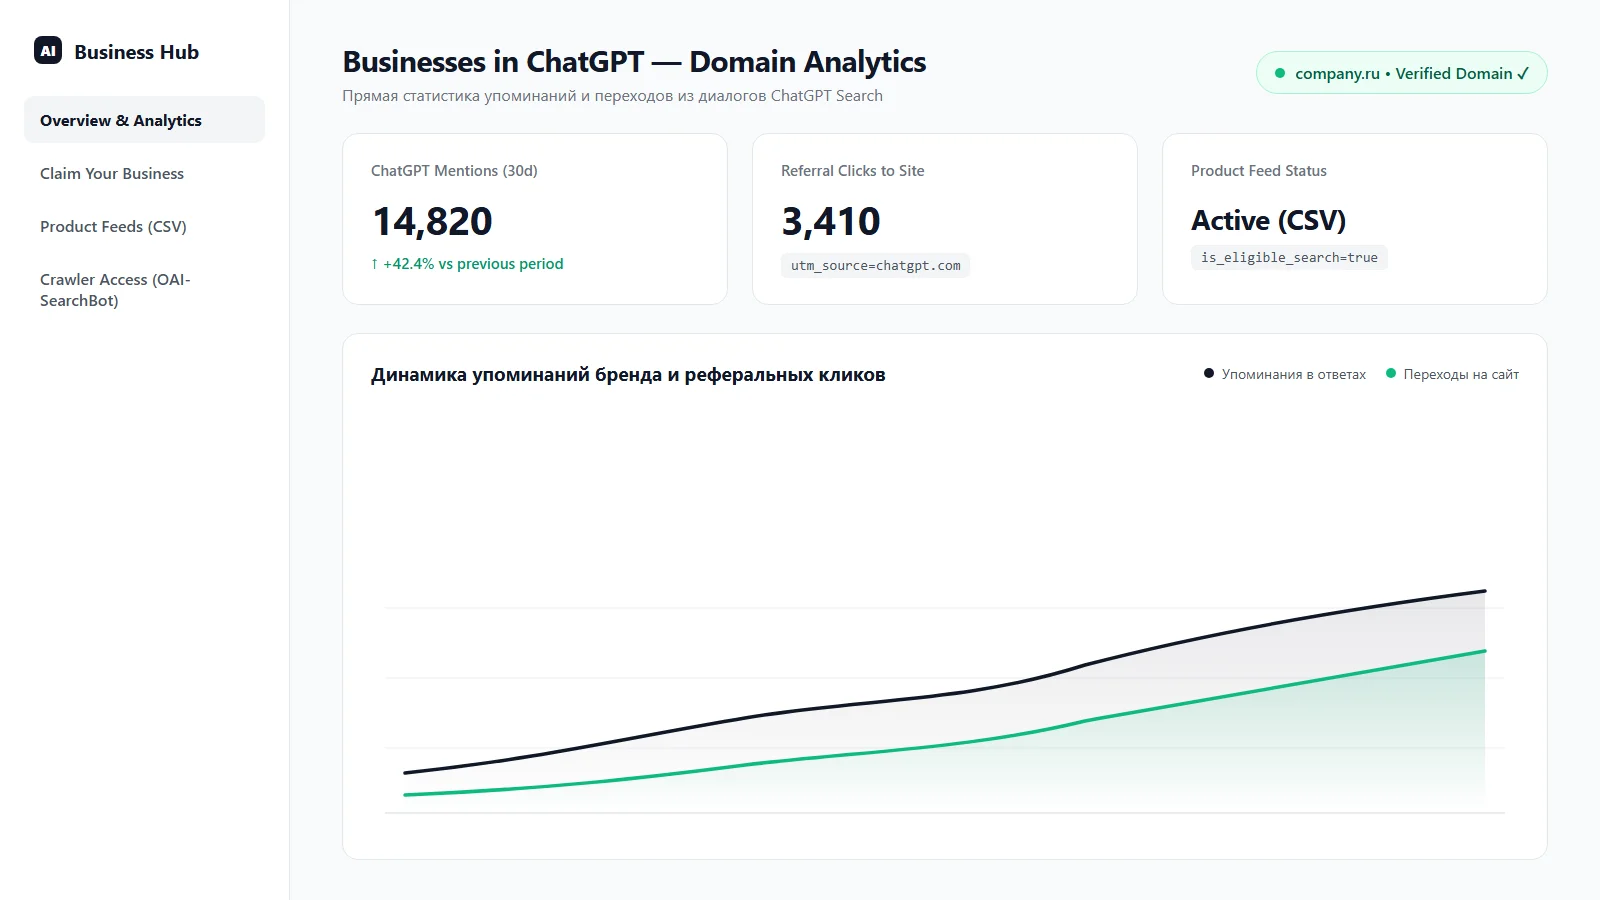
Интерфейс OpenAI Business Hub: верификация домена, статистика упоминаний в ChatGPT и статус товарного фида
Как отслеживать GEO-трафик в Google Search Console и системах аналитики
В Google Search Console показы и клики из AI Overviews и AI Mode объединены с общей органической статистикой в отчете «Эффективность». При этом важно учитывать особенность подсчета позиций: все ссылки, попавшие в один блок AI Overviews, получают в отчете GSC одинаковую позицию. Также стоит заглянуть в настройки ресурса в Search Console и убедиться, что не активирован запрет на участие в генеративных функциях поиска (Search generative AI opt-out), который стал доступен для всех сайтов в августе 2026 года.
Для измерения реального трафика из диалоговых нейросетей настройте сегменты в Google Analytics 4 или Яндекс.Метрике:
- OpenAI автоматически добавляет ко многим исходящим ссылкам параметр
utm_source=chatgpt.com— отслеживайте его в связке с рефереромchatgpt.com. - Отдельно контролируйте реферальные переходы с доменов
perplexity.ai,gemini.google.comиcopilot.microsoft.com.
Вся правда про llms.txt и микроразметку
Вокруг GEO успело возникнуть немало мифов, главный из которых — необходимость создавать в корне сайта файл llms.txt со специальной Markdown-разметкой для нейросетей. 15 июня 2026 года Google обновил официальное руководство AI Optimization Guide в Search Central и поставил в этом вопросе точку: поиск Google и AI Overviews полностью игнорируют файл llms.txt, его наличие никак не влияет на ранжирование. (Появление проверки llms.txt в Chrome Lighthouse 13.3 связано исключительно с экспериментальным аудитом агентского браузинга и протокола WebMCP, но не с поисковыми алгоритмами).
Вместо создания нестандартных текстовых файлов сосредоточьтесь на классической валидной микроразметке Schema.org (Organization, Product, FAQPage, Article). Она помогает краулерам безошибочно связывать сущности — например, понимать, что конкретная цифра на странице является актуальной ценой товара в рублях или долларах, а не артикулом. Кроме того, проверьте метатеги страниц: директива nosnippet или слишком жесткое ограничение max-snippet запрещают Google использовать фрагменты вашего текста при генерации AI Overviews.
Популярные нейросети без подписок
5. Редакционные стандарты GEO: как писать тексты, которые забирают в цитаты
Когда нейросеть собирает информацию по веерным подзапросам, она сканирует десятки страниц за доли секунды. Чтобы алгоритм выбрал именно ваш абзац и поставил на него инлайн-ссылку, текст должен быть написан по правилам, облегчающим машинное извлечение фактов.
Принцип «цитируемого предложения» (Quotable Sentences)
После октябрьского апдейта Google встраивает гиперссылки прямо в конкретные слова и утверждения внутри первых абзацев AI Overviews. Если ваша мысль размазана на пять витиеватых предложений, модели сложно выделить конкретный фрагмент для привязки ссылки. Гораздо выше шансы у емких, самодостаточных формулировок, построенных по схеме: «[Сущность] — это [четкое определение], которое решает [задачу] за счет [измеримая характеристика]».
Посмотрим на разницу на конкретном примере.
Как писали в эпоху классического SEO (плохо для GEO):
«В современном мире ни для кого не секрет, что выбор облачного хранилища для корпоративных данных является сложной и ответственной задачей для любого бизнеса. Наша компания предлагает передовые решения, которые позволяют гибко масштабировать инфраструктуру и обеспечивают высокий уровень безопасности. Ознакомиться с условиями подключения можно у наших менеджеров.
В этом абзаце нет ни одного проверяемого факта, за который могла бы зацепиться нейросеть: ни объемов, ни протоколов шифрования, ни стоимости. Модель проигнорирует такой блок.
Как нужно писать под GEO и Gemini 4 Hydrogen (хорошо):
«Облачное хранилище [Название] — это S3-совместимый объектный сторидж с шифрованием по стандарту AES-256 и гарантированной доступностью 99,98% по SLA. Базовый тариф для команд в 2026 году составляет 12 долларов за 1 ТБ в месяц без платы за исходящий трафик.
Здесь каждое слово несет конкретику: стандарт совместимости, алгоритм шифрования, процент SLA, точная цена и условие тарификации. ИИ легко извлечет эти параметры для ответа пользователю и поставит прямую ссылку на страницу тарифов.
Перевернутая пирамида и отказ от «воды»
В журналистике этот прием называется перевернутой пирамидой: главный вывод и прямой ответ на вопрос выносятся в первые два-три предложения после подзаголовка, а детали, контекст и оговорки идут ниже. Избегайте вводных конструкций вроде «мы считаем», «возможно», «как правило» — они размывают фактическую точность текста. Нейросети отдают предпочтение нейтральному, энциклопедическому стилю (так называемому Wiki-Voice), где утверждения подкреплены цифрами, датами или ссылками на исследования.
Таблицы как главный магнит для Gemini 4 Hydrogen
С переходом Google AI Mode на модель Gemini 4 Hydrogen в ноябре 2026 года генеративная выдача стала гораздо чаще строить сводные сравнительные таблицы прямо внутри ответа. Если на вашей странице информация о тарифах, технических характеристиках или отличиях моделей уже оформлена в виде чистой HTML-таблицы с понятными заголовками столбцов (<th>), алгоритму не нужно парсить сплошной текст — он напрямую забирает структурированные данные и ссылается на вас как на первоисточник.
Свежесть данных и визуальные карточки
Помня о том, что год 2026 присутствует почти в четверти всех веерных подзапросов ChatGPT, поддерживайте актуальность ключевых материалов. Выносите год обновления в заголовок, вовремя убирайте устаревшие скриншоты и статистику двухлетней давности. Кроме того, уделите внимание заглавным изображениям статей (og:image): после октябрьского обновления Google в нижней части AI Mode и AI Overviews выводятся крупные карточки похожих материалов с миниатюрами. Четкая, контрастная обложка без мелкого нечитаемого текста напрямую повышает CTR из рекомендательного блока ИИ.
6. Внешний контур (Off-Page GEO): как формируется авторитет бренда для нейросетей
В классическом SEO авторитетность сайта измерялась количеством и качеством обратных ссылок (бэклинков). В GEO на первый план выходит консенсус упоминаний (Brand Mentions / Co-occurrence). Когда генеративная модель анализирует рынок, она сопоставляет данные из множества независимых источников. Если название вашего продукта регулярно встречается рядом с решением конкретной проблемы на трастовых площадках — даже без активной гиперссылки — нейросеть фиксирует эту устойчивую семантическую связь и начинает рекомендовать бренд в ответах.
Исследования цитирования осени 2026 года подсказывают три приоритетных направления для работы за пределами собственного сайта:
- YouTube с подробными текстовыми транскриптами. По данным Comscore и аудита Dartmouth (сентябрь 2026), YouTube удерживает статус самого цитируемого домена в Google AI Overviews. Более того, в AI Mode Google внедряет кликабельные профили авторов и издателей прямо на видеорезультатах. Чтобы нейросети могли индексировать ваши ролики, недостаточно просто залить видео: необходимо загружать вычитанные субтитры, разбивать ролик на тайм-коды с четкими названиями глав и дублировать ключевые тезисы в описании.
- Присутствие в локальном инфополе. Аудит Dartmouth показал, что при запросах на родном языке пользователя доля локальных источников в ответах ИИ вырастает в 3,5–13,5 раза по сравнению с англоязычными промптами. Для русскоязычного сегмента критично присутствие на профильных ресурсах с высоким доверием поисковиков (Habr, VC.ru, отраслевые рейтинги, каталоги софта и агрегаторы отзывов), где ваш продукт разбирается в контексте реальных кейсов.
- Работа с функцией Preferred Sources в Google. Учитывая семикратный рост популярности «Предпочитаемых источников» в поиске Google, регулярной аудитории блога или медиа стоит прямо напоминать о возможности добавить ваш сайт в список предпочитаемых источников — это гарантирует приоритетный показ ваших публикаций в новостных каруселях AI Search для лояльных читателей.
7. Пошаговый план внедрения GEO на 30 дней
Чтобы перевести сайт на рельсы генеративной оптимизации без хаоса, работу удобно разбить на четыре недельных спринта.
Первая неделя — техническая диагностика и подключение кабинетов. Проведите ревизию robots.txt и правил фаервола на уровне CDN/хостинга: убедитесь, что OAI-SearchBot, ChatGPT-User, Claude-SearchBot и PerplexityBot свободно сканируют страницы, а контент отдается в чистом HTML. Зарегистрируйте компанию и подтвердите домен в ChatGPT Business Hub, проверьте настройки индексации в Bing Webmaster Tools и убедитесь, что в Google Search Console не включен запрет на генеративные функции поиска.
Вторая неделя — переработка топ-10 приоритетных страниц. Выберите десять посадочных страниц или статей, которые приносят наибольшую выручку или лиды. Добавьте в начало каждой из них блок TL;DR с прямой выжимкой фактов. Перепишите размытые вступления по принципу Answer-First, сформулируйте ключевые преимущества в виде цитируемых предложений и переведите текстовые описания цен и характеристик в структурированные HTML-таблицы.
Третья неделя — актуализация данных, микроразметка и фиды. Обновите цифры, тарифы и заголовки под реалии конца 2026 года, чтобы попадать в веерные подзапросы с модификатором года. Проверьте валидность разметки Schema.org (Organization, Product, FAQPage, Article) и обновите обложки og:image для корректного отображения в карточках Google AI Mode. Если у вас интернет-магазин, настройте регулярную генерацию CSV-фида для OpenAI с флагом is_eligible_search=true.
Четвертая неделя — внешняя дистрибуция и запуск аналитики. Выпустите видеоверсии ключевых гайдов или обзоров на YouTube с полными текстовыми расшифровками и тайм-кодами. Договоритесь о включении вашего продукта или актуальных данных в независимые отраслевые подборки и обзоры на трастовых площадках. В Google Analytics 4 или Яндекс.Метрике настройте отдельный дашборд для отслеживания переходов по utm_source=chatgpt.com, perplexity.ai и gemini.google.com, а также еженедельно сверяйте динамику упоминаний в ChatGPT Business Hub.
❓ Частые вопросы (FAQ)
Заменит ли GEO классическое SEO в 2027 году?
Нужно ли закрывать сайт от GPTBot, чтобы нейросети не учились на моих статьях?
GPTBot и ClaudeBot оправдана. Если же вы продаете товары, софт или B2B-услуги, открытый доступ для обучающих ботов играет вам на руку: модель запоминает ваш бренд на уровне базовых весов и начинает рекомендовать его даже в тех 85,6% диалогов, где поиск в интернете не запускается. При этом поисковый бот OAI-SearchBot должен оставаться открытым при любой модели монетизации.
Почему ChatGPT упоминает нашу компанию в ответе, но не ставит активную ссылку на сайт?
Имеет ли смысл поддерживать файл llms.txt для продвижения в поиске?
llms.txt не нужно — Google официально подтвердил в документации Search Central, что поисковые алгоритмы этот файл игнорируют. Единственный сценарий, где он может пригодиться, — сложная техническая документация для разработчиков (API или SDK), с которой напрямую работают специализированные ИИ-агенты в средах разработки.




Комментарии и обсуждение
Пока нет комментариев. Будьте первым!