
9 ноября 2026 года Anthropic представила Claude Fable 5.2 и закрытую версию Claude Mythos 5.2. Одновременно с релизом компания опубликовала руководство по выбору моделей, в котором прямо рекомендовала не использовать новинку по умолчанию, а начинать работу с Claude Opus 5.5.
За первые сутки вокруг Fable 5.2 сложились противоречивые оценки. В комментариях на X, Reddit и Hacker News разработчики критикуют модель за большой расход токенов, слабую работу с интерфейсами и излишнюю педантичность.
Ниже — подробный разбор модели по данным официальной документации, гайда для разработчиков и первых отзывов пользователей.
Что такое Claude Fable 5.2 и чем она отличается от Mythos 5.2
Согласно документации Anthropic, Claude Fable 5.2 (claude-fable-5-2) и Claude Mythos 5.2 (claude-mythos-5-2) основаны на одной базовой модели с одинаковыми ценами и техническими лимитами. Отличие состоит в правилах безопасности и доступе:
- Fable 5.2 доступна всем пользователям в Claude API, платных подписках Claude, а также на Amazon Bedrock, Google Cloud и Microsoft Foundry. В модель встроены классификаторы, которые блокируют задачи, связанные с поиском уязвимостей, тестированием на проникновение, эксплойтами и прикладной биологией.
- Mythos 5.2 предназначена для специалистов по кибербезопасности и биомедицине, поэтому часть ограничений в ней снята. Доступ выдаётся только верифицированным организациям через программы Cyber Verification Program и Life Sciences Verification Program.
Основные параметры обеих версий: контекстное окно 1 млн токенов (около 555 тыс. слов на токенизаторе Opus 4.7), максимальный размер ответа — 128 тыс. токенов, срез обучающих данных — июнь 2026 года.
| Модель | Описание | Доступность |
|---|---|---|
| Claude Fable 5.2 | Для сложных рассуждений и длительной агентной работы | Все клиенты Claude API (для партнёрских платформ см. страницу каждой платформы) |
| Claude Mythos 5.2 | Те же возможности, что и у Claude Fable 5.2 | Организации, прошедшие проверку в рамках программ верификации Anthropic, таких как Cyber Verification Program |
Цены, скорость и режимы работы
Базовый тариф API снизился на 20% по сравнению с поколением 5.1 (где миллион входных и выходных токенов стоил $10 и $50):
- Стандартный режим: $8 за 1 млн входных токенов и $40 за 1 млн выходных.
- Кэширование промптов: чтение из кэша стоит $0,20 за 1 млн токенов (2,5% от цены входа), запись на 5 минут — $10, на 1 час — $16.
- Batch API (пакетная обработка): скидка 50% — $4 / $20 за миллион токенов.
- Fast Mode (ускоренный режим): повышает скорость генерации до 2,5 раза, но стоит вдвое дороже — $16 / $80 за 1 млн токенов (в Microsoft Foundry модель выделена как claude-fable-5-2-fast).
В обычном режиме скорость генерации выросла примерно на 30% относительно Fable 5.1.
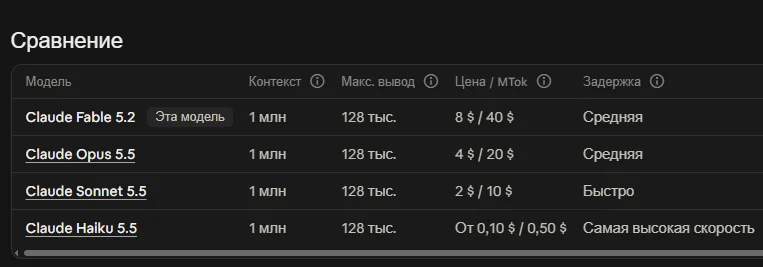
Сравнение последних моделей от Anthropic
Почему сама Anthropic советует начинать с Opus 5.5
Одновременно с выходом модели Addy Osmani опубликовал на блоге claude.dev руководство по выбору моделей Claude. Главная рекомендация простая: Fable 5.2 стоит использовать точечно, а базовой моделью для большинства задач остаётся Opus 5.5.
Позиционирование актуальной линейки выглядит так:
| Модель | Рекомендуемые задачи |
|---|---|
| Haiku 5.5 | Классификация, маршрутизация, извлечение данных, субагенты для поиска по файлам и логам |
| Sonnet 5.5 | Повседневная разработка по понятному ТЗ, багфиксы, чаты, документы, таблицы и слайды |
| Opus 5.5 | Основная рабочая модель: сложное программирование, многофайловые задачи, анализ и Computer Use |
| Fable 5.2 | Масштабный рефакторинг и миграции, архитектура, научные и финансовые расчёты, оркестрация субагентов |
Почему режим Max оказался невыгодным
В руководстве Anthropic советует начинать разработку с Opus 5.5 на среднем усилии (medium) — именно эта конфигурация стоит по умолчанию в Claude Code. Поднимать Opus 5.5 выше high часто не имеет смысла: уровень xhigh увеличивает стоимость в 2,5 раза ради прироста в 1,4 балла. На самых сложных задачах действительно выгоднее перейти на Fable 5.2 с high.
На тесте FrontierCode 2.0 это подтверждается цифрами: Fable 5.2 на high набрала 45,3% при стоимости $6,72 за задачу — почти столько же, сколько максимум Opus 5.5 (45,5% за $12,82). Но на максимальных настройках Fable 5.2 экономика резко портится:
- На уровне Xhigh Fable 5.2 показывает лучший результат 49,1% при средней цене задачи $14,19.
- На максимальном уровне Max стоимость задачи вырастает более чем в три раза — до $44,70, а точность снижается до 45,6% из-за избыточного усложнения кода (overthinking).
- По независимым замерам Artificial Analysis, на уровне Max Fable 5.2 генерирует в 1,7 раза больше выходных токенов, чем Fable 5.1, из-за чего стоимость прогона выросла с $12,99 до $26,54.
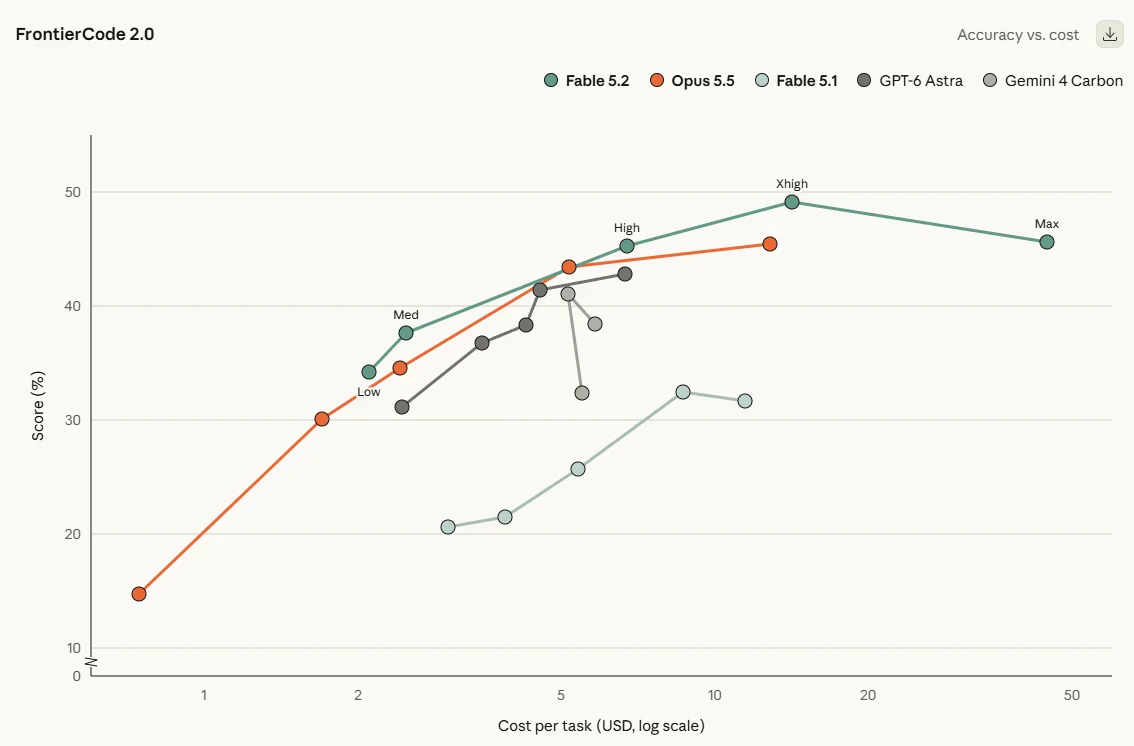
График Accuracy vs. cost на FrontierCode 2.0: пик на Xhigh (49,1% за $14,19) и снижение результата на Max (45,6% за $44,70)
Ещё одна деталь: тестирование инструмента Advisor (когда более дешёвая модель запрашивает помощь у старшей) показало неоднозначный результат. Связка «Opus 5.5 + советник Fable 5.1» добавила 1,7 балла на внутреннем тесте, но увеличила цену в 2,1 раза. Гораздо эффективнее оказалось поручать Opus 5.5 планирование, а чтение файлов и сбор контекста отдавать параллельным субагентам на Sonnet 5.5 или Haiku 5.5 — на базе в 22 млн токенов это сократило расходы на треть при том же качестве.
Что пишут разработчики: разбор отзывов из X, Reddit и Hacker News
Наряду с отчётами корпораций в сети появились первые впечатления независимых разработчиков. Широкое обсуждение собрал пост engineering manager под ником @Gegam245074 в X (около 100 тысяч просмотров).
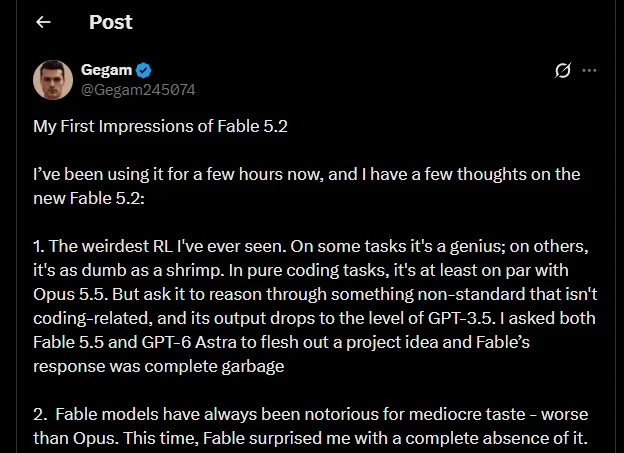
Оригинальный тред @Gegam245074 в X с первыми впечатлениями от Fable 5.2
- Неравномерное обучение с подкреплением (RL). В задачах программирования модель показывает результат как минимум на уровне Opus 5.5. Но при переходе к нестандартным не-кодинговым задачам — например, к детальной проработке идеи нового проекта — качество резко снижается. В прямом сравнении с GPT-6 Astra автор ветки назвал ответ Fable неудачным, сравнив его с уровнем GPT-3.5.
- Слабая работа с интерфейсами (UI/UX). Пользователи отмечают проблемы со вкусом в дизайне. В одном из тестов на длинном списке Fable 5.2 добавила сразу два независимых элемента пагинации: первый раскрывал уже загруженные данные, а второй под ним подгружал новый контент. В официальной матрице Anthropic для документов, презентаций и интерфейсов рекомендует Sonnet 5.5 или Opus 5.5.
- Высокий расход токенов. Разработчики в X жалуются, что в реальных рабочих сессиях Fable 5.2 расходует в 3–4 раза больше токенов, чем Fable 5.1, из-за чего 20-процентное снижение цены в API не даёт экономии. В документации Anthropic есть прямое объяснение: на уровне medium и выше модель игнорирует указания в промпте вроде «отвечай сразу, без размышлений» и продолжает тратить токены на внутреннее обдумывание.
- Излишняя педантичность. По наблюдениям пользователей, модель часто пытается оспорить формулировки в запросе: «скажите ей, что снег белый, и она найдёт миллион причин, почему это не совсем точно». Похожую особенность ранее критиковали в GPT-6 Astra. В корпоративных отзывах (например, Balyasny Asset Management) эту же черту оценивают положительно: при финансовом анализе модель вовремя указывает на некорректную постановку вопроса.
- Скорость на среднем усилии. При reasoning effort = medium (значение по умолчанию в Claude Code и приложениях Claude) ответы приходят почти мгновенно — прирост скорости на 30% заметен на практике.
- Тщательность и самопроверка (diligence). Модель переняла качество, характерное для Sonnet 5.5: она самостоятельно проверяет код, находит ошибки и делает несколько итераций до стабильного результата. При этом документация предупреждает, что на уровнях low и medium в длинных задачах Fable 5.2 иногда останавливается раньше завершения и выводит список оставшихся шагов.
- Близость к Opus 5.5 и объяснение индекса 5.2. В программировании разница между Fable 5.2 и Opus 5.5 небольшая, а по цене ($4/$20 против $8/$40), дизайну и предсказуемости лимитов Opus 5.5 остаётся удобнее для ежедневной работы. В обсуждениях сходятся на том, что модель назвали 5.2, а не 5.5, поскольку заметного скачка для массовых сценариев не произошло. Для знакомства с моделью Anthropic начислила владельцам подписок Pro и Team от одного до трёх дополнительных сбросов лимитов (Fable resets).
Какую модель выбрать под конкретную задачу
- Claude Fable 5.2 (medium или high, реже xhigh) имеет смысл брать для крупных миграций кода (например, с Python на Rust), оркестрации десятков субагентов, сложной финансовой аналитики и научных расчётов.
- Claude Opus 5.5 (medium / high) остаётся оптимальным выбором для ежедневной разработки, проработки продуктовых идей, задач Computer Use и сценариев, где важна предсказуемая стоимость.
- Claude Sonnet 5.5 и Haiku 5.5 лучше подходят для интерфейсов, документов, быстрых правок по ТЗ и массовых субагентов.
- Низкоуровневая оптимизация GPU: для задач с CUDA и ядрами видеокарт Fable 5.2 не даст преимущества перед Opus 5.5 из-за ограничений, заложенных при обучении.
Сравнить ответы актуальных моделей Claude и конкурентов в одном интерфейсе без зарубежных карт и регистрации иностранных аккаунтов можно в ИИ-студии Нейро.PRO.


Комментарии и обсуждение
Пока нет комментариев. Будьте первым!